照片方程式 OCR 指南
我怎麼從照片讀方程式,但不盲信 OCR
作者:Evan Li已更新
照片輸入最容易犯的錯,是把 OCR 當成數學求解器。它不是;OCR 只是從像素猜文字。所以我的流程固定是『照片 → 辨識文字 → 人工確認 → solver』。多這一步,可以避免 OCR 看錯一個符號後,系統卻很認真地把錯的方程式算對。
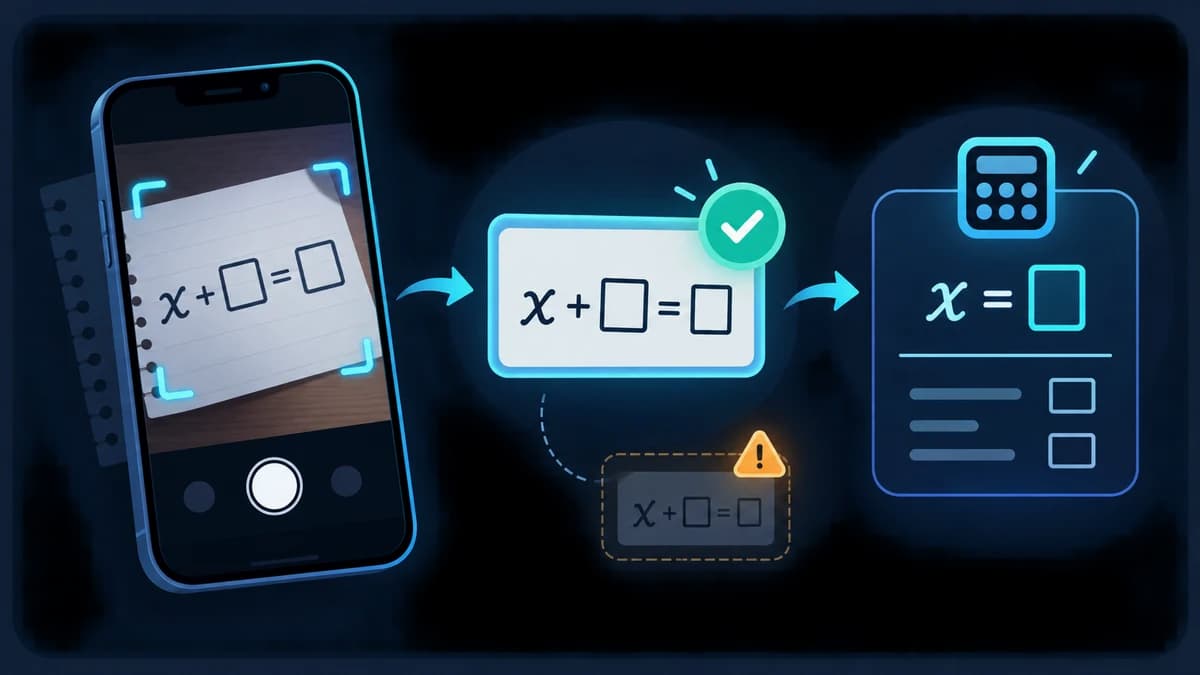
我拍照追求可讀性,不追求好看
我會盡量只裁一個方程式,讓鏡頭和紙面平行,避免陰影,並讓 x、×、1、l、0、O 不要糊在一起。印刷體通常最好辨識,但清楚的手寫也可能成功。
如果一張紙上有很多題,OCR 不知道我想解哪一行。現在的功能會優先挑有 x 和等號的行,但這只是啟發式。把目標方程式裁緊一點更可靠。
我會先懷疑幾種最容易誤讀的數學符號
上標、分數線、根號、負號、乘號都很常出錯。x² 可能變 x2,√ 可能像 v,絕對值的直線也可能被辨識成 1。
辨識完成後,我會針對這些符號逐一和原圖比對。原圖是 x² - 5x + 6 = 0,但輸入框卻是 x2 - 5x + 6 = 0,我一定先修正次方再求解。
OCR 文字回到一般輸入框,是刻意設計的
辨識結束後不會自動 Solve。辨識到的那一行會放回和手動輸入、LaTeX 共用的欄位,因此我可以編輯,也能在 parser 看得懂時用 MathML 預覽再次檢查。
我確認完才按 Solve。之後 OCR 和手動輸入走的是完全相同的正規化、parser、solver、步驟、驗算與圖形流程。
我把 OCR 的隱私邊界寫清楚
支援的方程式求解本身不需要外部數學 API。啟用 OCR 時,瀏覽器只會從本站載入 Tesseract.js 與辨識資源。辨識運算與圖片都留在瀏覽器中,不會把圖片傳送給第三方 OCR 服務。
共享的 ?q= URL 也會把方程式放進網址,因此不應把敏感資訊當成方程式內容;分享前也應再次確認網址列。
OCR 一直讀錯時,我就切換到最快的可靠方法
短方程式直接打字通常更快;來源本來就有 LaTeX,直接貼 LaTeX 通常更準;手寫太模糊時,我寧可人工轉錄,再用預覽檢查。
目的不是證明 OCR 能讀所有作業紙,而是清楚圖片時少打一點字,同時在真正做數學前,最後的方程式仍由我自己確認。