画像 OCR ガイド
OCR を盲信せず写真から方程式を読み取る方法
画像入力で一番避けたかったのは、OCR を数学ソルバーのように扱うことでした。OCR がしているのは画像から文字を推定することです。だから私は『写真 → 認識文字 → 人が確認 → 求解』の順番にします。この一段を入れるだけで、誤読した式に対して正しく計算してしまう事故を減らせます。
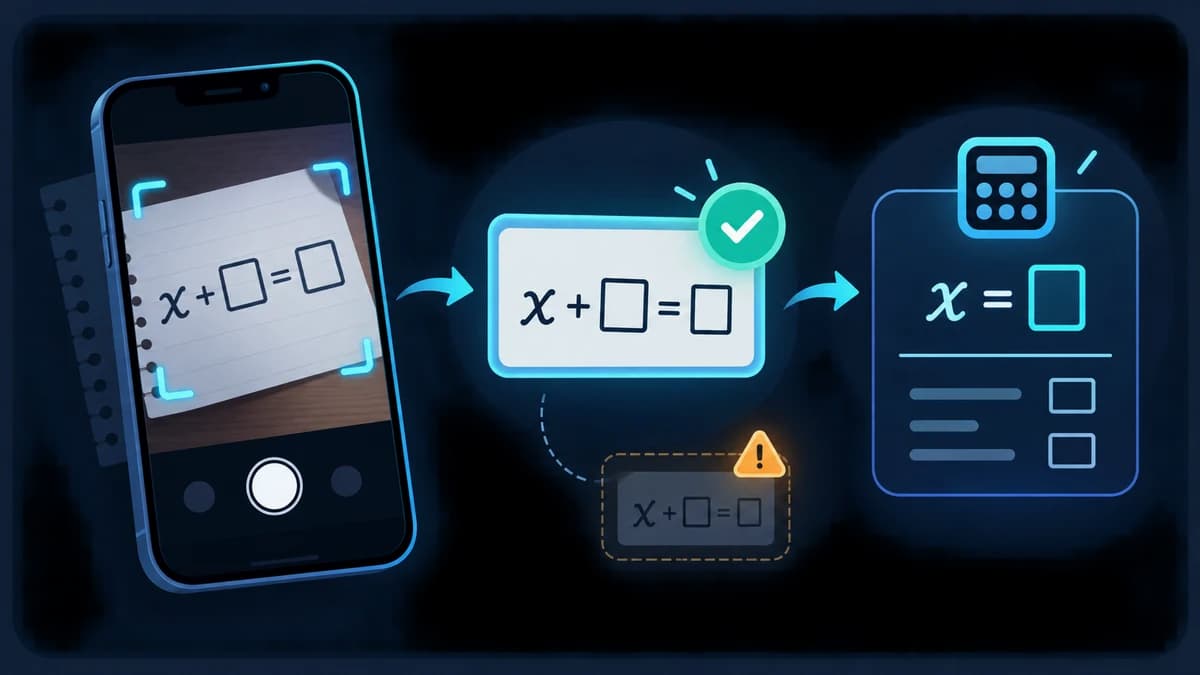
きれいな写真より、読みやすい写真を撮ります
一つの方程式だけを大きく切り取り、紙に対してカメラをできるだけ平行にし、影を避けます。x、×、1、l、0、O が潰れない大きさにするだけでも認識しやすくなります。印刷された式の方が安定しますが、はっきりした手書きなら読める場合もあります。
一枚に複数の問題があると、OCR は私がどの行を解きたいか知りません。現在の機能は x や = が含まれる行を優先しますが、あくまでヒューリスティックです。必要な式だけを切り取る方が確実です。
誤読しやすい数学記号を先に疑います
上付きの 2、分数線、根号、マイナス、掛け算記号は特に誤認識しやすいです。x² が x2 になったり、√ が v に見えたり、絶対値の縦棒が 1 になることもあります。これは代数のミスではなく OCR の限界です。
認識後は危険な記号の周辺を画像と見比べます。写真が x² - 5x + 6 = 0 なのに入力が x2 - 5x + 6 = 0 なら、求解前に指数を直します。
認識結果を通常の入力欄へ戻すのは意図的です
OCR が終わった瞬間に自動で Solve しないようにしています。認識した一行は通常の方程式入力欄へ入るので、自分で編集し、必要なら MathML プレビューを確認できます。
確認後に Solve を押せば、そこから先は手入力と同じです。同じ正規化、parser、solver、途中式、検算、グラフを使います。
OCR のプライバシー範囲を明確にします
通常の方程式求解に外部の数学 API は必要ありません。OCR を使うときは、このサイトから Tesseract.js と認識用データを読み込みます。認識処理と画像はブラウザ内に留まり、外部 OCR 事業者へ画像は送信されません。
共有用 ?q= URL を作ると方程式が URL に含まれるため、個人情報や機密情報を入力しないようにしています。
うまく読めないときは、一番速くて確実な方法へ切り替えます
短い式なら手入力の方が速いです。元の資料に LaTeX があるなら、LaTeX を貼る方が正確です。手書きが曖昧なら自分で転記し、プレビューを確認します。
目的は OCR があらゆる答案用紙を読めると証明することではありません。明瞭な画像からの打ち直しを減らしつつ、数学を始める前に最終的な式を自分で管理できることを重視しています。