Guide OCR pour équations
Comment je scanne une équation sans faire confiance aveuglément à l’OCR
Par Evan LiMis à jour
L’erreur que je voulais éviter avec l’entrée photo était de traiter l’OCR comme un solveur. Ce n’en est pas un : il devine des caractères à partir de pixels. Mon ordre est donc photo → texte reconnu → relecture humaine → résolution. Cette relecture empêche une mauvaise transcription de produire une réponse mathématiquement correcte à la mauvaise équation.
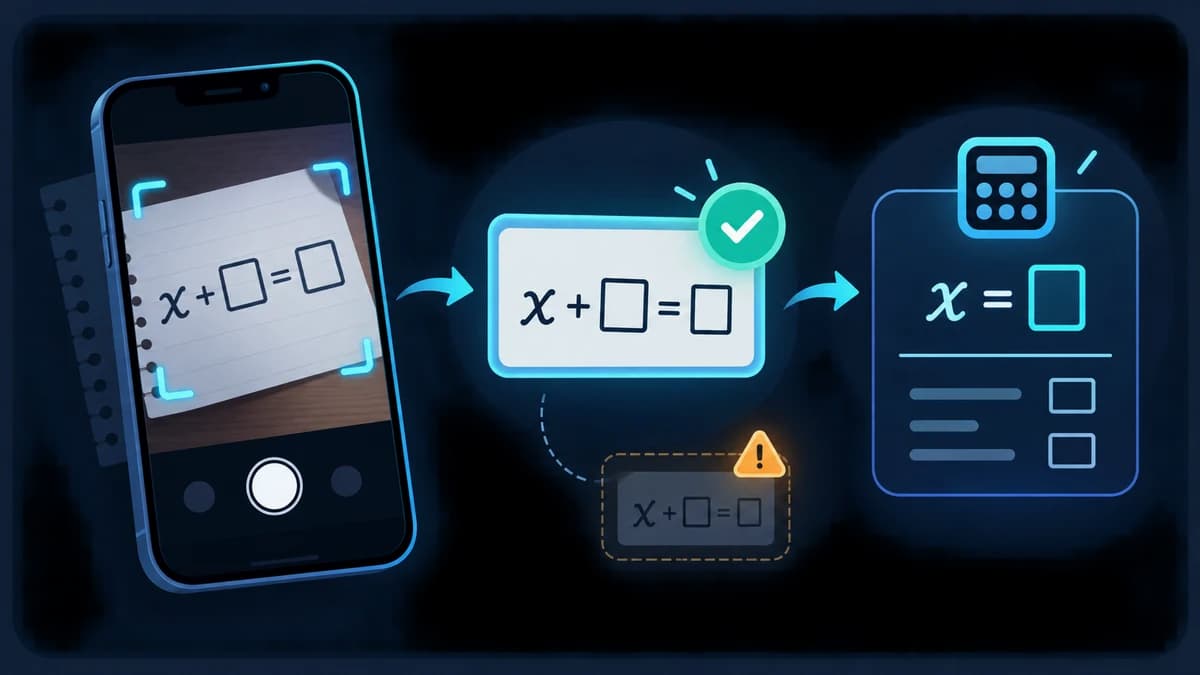
Je photographie pour la lisibilité, pas pour faire une belle page
Je recadre une seule équation, je garde l’appareil aussi parallèle que possible au papier, j’évite les ombres et je m’assure que x, ×, 1, l, 0 et O restent distincts. Les équations imprimées sont plus faciles, mais une écriture manuscrite nette peut également fonctionner.
S’il y a plusieurs exercices, l’OCR ne sait pas lequel m’intéresse. Le système donne davantage de poids aux lignes contenant x et =, mais ce n’est qu’une heuristique. Un recadrage serré reste plus fiable.
Je m’attends à des erreurs sur certains symboles
Les exposants, barres de fraction, racines, signes moins et signes de multiplication posent souvent problème. x² peut devenir x2, √ peut ressembler à v et des barres de valeur absolue à des chiffres 1.
Après reconnaissance, je compare donc l’image et le texte autour de ces symboles. Si la photo contient x² - 5x + 6 = 0 mais que le champ indique x2 - 5x + 6 = 0, je corrige l’exposant avant de résoudre.
Le résultat OCR revient dans le champ normal exprès
Je ne lance pas automatiquement Solve après la reconnaissance. Le texte revient dans le même champ que la saisie manuelle ou LaTeX, ce qui me permet de l’éditer et de regarder l’aperçu MathML quand il est disponible.
Une fois le texte validé, le reste du parcours est identique : normalisation, parseur, solveur, étapes, vérification et graphique.
Je distingue clairement le calcul local de l’OCR
La résolution des équations prises en charge ne demande pas d’API mathématique tierce. L’OCR facultatif charge Tesseract.js et ses ressources depuis ce site au moment où je l’utilise. La reconnaissance et l’image restent dans le navigateur ; aucune image n’est envoyée à un fournisseur d’OCR tiers.
J’évite également d’insérer des informations sensibles dans une équation ou dans une URL partageable contenant ?q=.
Quand l’OCR lutte, je choisis le raccourci le plus fiable
Pour une équation courte, la saisie manuelle est parfois plus rapide. Si la source contient déjà du LaTeX, le copier-coller LaTeX est plus précis. Si l’écriture est ambiguë, je transcris moi-même et je contrôle l’aperçu.
Le but n’est pas de faire croire que l’OCR peut lire n’importe quelle feuille. Il doit simplement réduire la ressaisie lorsque l’image est nette, tout en me laissant le dernier mot sur l’équation avant le calcul.